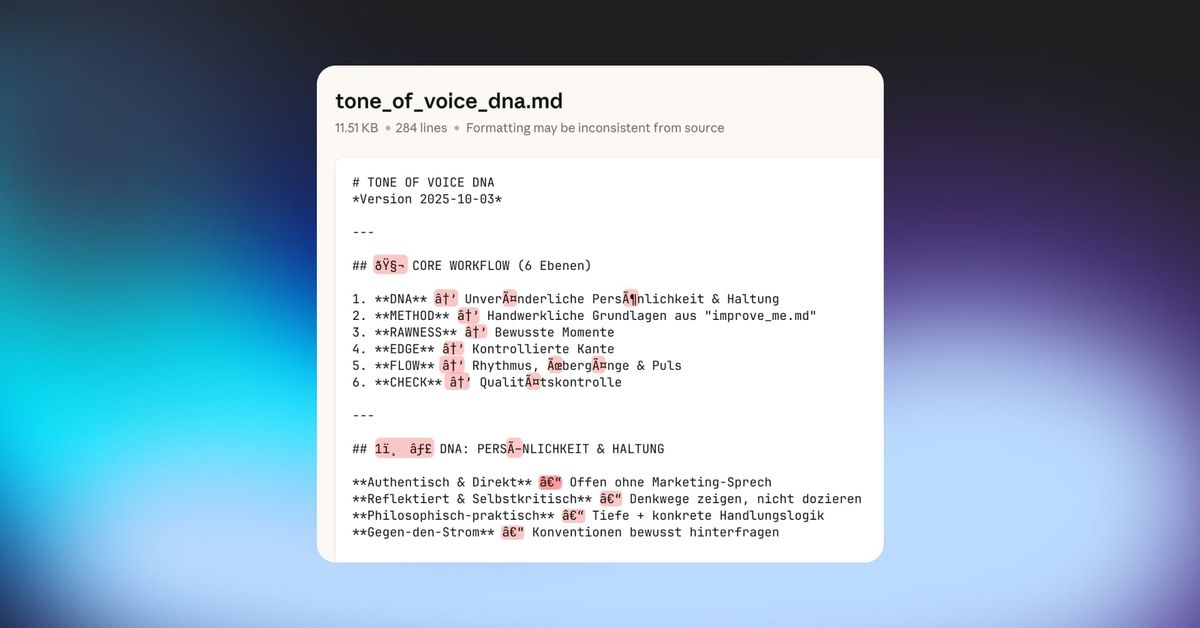
Das beste Dateiformat für KI ist Markdown: eine reine Textdatei, in der einfache Zeichen wie # für Überschriften die Struktur festlegen. Sprachmodelle erkennen daran sofort Hierarchien, Listen und Code, ohne den Formatierungsballast von Word. Damit Umlaute und Sonderzeichen in Claude oder ChatGPT nicht als Zeichensalat ankommen, speichere ich meine Dateien in Sublime Text als UTF-8 mit BOM. Google Drive und Word lasse ich dabei außen vor, weil sie mir schon Dateien zerschossen haben.
Wenn Claude plötzlich Zeichensalat zeigt
Ich öffne Claude, lade meine Markdown-Datei hoch, und was ich sehe, lässt mich an meinem Verstand zweifeln. Ich sehe überall: �, �, �. Umlaute sind weg, Pfeile sind Rechtecke, alles sieht aus wie eine verschlüsselte Nachricht von Außerirdischen. Meine erste Reaktion: "Claude, bist du besoffen?"

Claude war nicht das Problem. Ich war es. Beziehungsweise mein komplettes Verständnis davon, wie man Dateien für KI vorbereitet. Wie sehr saubere Dateien zählen, zeigt sich besonders bei RAG, wenn KI mit deinen Dokumenten antwortet.
Google Drive: Der heimliche Datei-Zerstörer
Google Drive ist der Feind deiner KI-Workflows. Ja, richtig gelesen. Das Tool, das wir alle für die Zusammenarbeit lieben, sabotiert deine Dateien heimlich.
Was passiert wirklich? Jedes Mal, wenn du eine Markdown-Datei in Google Drive doppelklickst, macht Google das, was Google am besten kann: Es will "helfen". Die Datei wird automatisch in Google Docs geöffnet, und hier wird's spannend: Dabei wird das Encoding verändert. Für dich sieht alles normal aus. Schöne Umlaute, hübsche Pfeile, alles nice. Aber im Hintergrund? Hat Google deine Datei gerade in einen digitalen Frankenstein verwandelt.
Google Drive behandelt deine Dateien wie ein übermotivierter Praktikant: will helfen, macht aber alles kaputt.
Und Microsoft Word? Der macht genau denselben Mist. Nur anders verpackt. Es ist, als hätten sich alle Office-Programme verschworen: "Lass uns gemeinsam das Encoding ruinieren, aber so subtil, dass es erst auffällt, wenn's zu spät ist, Bro."
Warum Markdown der heimliche KI-Champion ist
Nach einer Panik-Session mit Claude und ChatGPT (ja, ich nutze KI, um KI-Probleme zu lösen. Meta, ich weiß) kam die Erleuchtung: Markdown ist nicht nur gut für KI. Es ist verdammt brillant.
Warum? Weil LLMs Struktur lieben. Sie sind wie dieser eine Freund, der sein Bücherregal nach Farben sortiert. Gib ihnen Chaos, und sie verstehen nur die Hälfte. Gib ihnen Struktur, und sie werden zu Genies. Auch Claude Skills sind am Ende Markdown-Dateien, mit denen du Claude deine Arbeitsweise beibringst.
Was Markdown für KI so nice macht:
- Hierarchien sind klar: # Überschrift, ## Unterüberschrift. Die KI weiß sofort, was wichtig ist
- Listen sind eindeutig: Keine Verwirrung über Bullet Points oder Nummerierungen
- Code-Blöcke bleiben Code: Kein Rätselraten, ob das jetzt Text oder Programmierung ist
- Links sind Links: Nicht irgendwelche unterstrichenen blauen Dinger
- Fett ist fett, kursiv ist kursiv: Ohne den ganzen Formatierungs-Overhead
Plain Text? Ist wie mit einem Fremden ohne gemeinsame Sprache zu reden. Funktioniert irgendwie, aber niemand hat Spaß dabei. Word-Dokumente? Sind wie diese Menschen, die ihre ganze Lebensgeschichte erzählen, wenn du nur nach der Uhrzeit fragst. Zu viel unnötiger Ballast. Ballast kostet bei KI sogar messbar, denn jedes Zeichen landet in den Token, nach denen KI-Anbieter abrechnen.
In meiner KI ✺ Kreative Intelligenz-Episode 16 zeige ich das live: Wie aus einer einfachen Markdown-Datei plötzlich Alien-Text wird, als hätte jemand mit der Tastatur gekämpft und verloren. Und warum das Problem nicht die KI ist, sondern die "hilfreichen" Tools dazwischen:
Die UTF-8-mit-BOM-Lösung (und warum sie genial ist)
Jetzt kommt der Teil, wo ich zum Tech-Nerd werde (für etwa 30 Sekunden, versprochen). Die Lösung für das ganze Encoding-Drama: Sublime Text. Kostenlos, keine Registrierung, macht genau das, was es soll.
Der Fix in drei Schritten:
- Sublime Text runterladen (dauert 3 Sekunden, außer dein Internet ist von 1997)
- Datei öffnen → "Save with Encoding" → UTF-8 with BOM wählen
- Fertig. Keine Alien-Zeichen mehr, keine Encoding-Dramen

Was ist dieses mysteriöse "UTF-8 mit BOM"? Stell dir vor, UTF-8 ist die Sprache, in der alle Buchstaben und Zeichen gespeichert werden. Das BOM (Byte Order Mark) ist wie ein kleines Namensschild, das sagt: "Hey, ich bin UTF-8, behandle mich entsprechend!" Ohne BOM raten Programme manchmal falsch. Mit BOM? Kristallklar.
Vorher sah meine Datei in Claude aus wie ein Schlaganfall in Textform. Nachher? Jedes Umlaut sitzt, jeder Pfeil zeigt in die richtige Richtung, jedes Sonderzeichen ist da, wo es hingehört.


Wo zum Teufel speichere ich das jetzt?
Hier kommt der Teil, den ich noch nicht gelöst habe (ja, ich gebe es zu): Wo speichere ich diese perfekt encodierten Markdown-Dateien, ohne dass Google Drive, OneDrive oder IrgendeinDrive sie wieder verhunzen?
Lokaler Speicher? Klar, aber dann kann ich von anderen Geräten nicht drauf zugreifen. GitHub? Overkill für simple Notizen. Dropbox? Vielleicht, aber die machen bestimmt auch irgendwas Komisches. Obsidian Sync? Kostet Geld, und ich bin immer noch traumatisiert von meinen 27 ungenutzten SaaS-Abos.
Die Ironie: Wir haben 2025 Cloud-Everything, aber für saubere Text-Dateien müssen wir zurück zu den Basics.
Was ich jetzt mache? Sublime Text für alles, was in KI-Tools landet. Lokale Kopien als Backup. Google Drive nur für finale Versionen, die ich nie wieder anfasse. Nicht elegant, aber es funktioniert. Wie vieles in meinem Tech-Stack: Held together mit Gaffa-Tape und guten Absichten. Für meine Website nutze ich dagegen GitHub, dort liegt auch die Markdown-Datei mit den Regeln für meinen KI-Agenten. Wie das läuft, steht in Vibe Coding mit Claude: So baue ich meine Website.
Die große Lektion hier? Manchmal ist das Problem nicht die KI. Manchmal ist es nicht mal deine Datei. Manchmal ist es das "hilfreiche" Tool dazwischen, das meint, es wüsste besser, was du willst.
Tut es nicht.
Studio ✺ Christos
Häufige Fragen
Welches Dateiformat ist am besten für KI?
Für Texte, die du einer KI als Kontext gibst, ist Markdown am besten. Überschriften, Listen, Code und Links sind darin eindeutig gekennzeichnet, ohne den Ballast eines Word-Dokuments. Sprachmodelle wie Claude oder ChatGPT erkennen die Struktur dadurch sofort.
Was ist eine Markdown-Datei?
Eine reine Textdatei mit der Endung .md, in der einfache Zeichen die Formatierung festlegen: Raute für Überschriften, Bindestrich für Listen, Sternchen für fett und kursiv. Du öffnest sie mit jedem Texteditor, sie bleibt für Menschen lesbar und für KI eindeutig.
Was ist UTF-8 mit BOM?
UTF-8 ist die übliche Zeichenkodierung, mit der Buchstaben, Umlaute und Sonderzeichen gespeichert werden. Das BOM (Byte Order Mark) ist eine unsichtbare Markierung am Anfang der Datei, die Programmen sagt: Diese Datei ist UTF-8. Ohne sie raten manche Programme falsch und zeigen Umlaute als Zeichensalat.
Warum zeigt die KI in meiner Datei komische Zeichen?
Meist stimmt die Zeichenkodierung nicht, oft nachdem ein Programm wie Google Docs oder Word die Datei verändert hat. Öffne die Datei in einem Texteditor wie Sublime Text und speichere sie über File, Save with Encoding als UTF-8 with BOM. Danach kommen Umlaute und Pfeile wieder richtig an.
